做外贸网站的朋友这两年最常问的一个问题就是:多语种内容到底能不能交给 AI?关于"外贸网站AI翻译"这件事,最近一份英译中的本地化基准测试给出了比"AI 赢了"细致得多的答案。它测了 774 份本地化产出,覆盖 6 种内容类型、7 类工作流模式(人工、中国 LLM、中国 LLM+译后编辑、西方 LLM、西方 LLM+译后编辑、机器翻译、机器翻译+译后编辑)、3 种任务类型(翻译、创译、创作),每个产出按准确性与一致性、流畅度与语言质量、风格与文化适配三个维度打分,各占总分三分之一,由以中文为母语的专业本地化人员盲评。这里不再重复谁赢谁输,而是想聊聊它真正能帮外贸团队改掉的三个选型习惯。先做一个必要的披露:这项研究由 EC Innovations 与 Jademond Digital 联合开展,两家公司都在卖与所评测做法相关的服务,看数据时心里要带着这层背景。
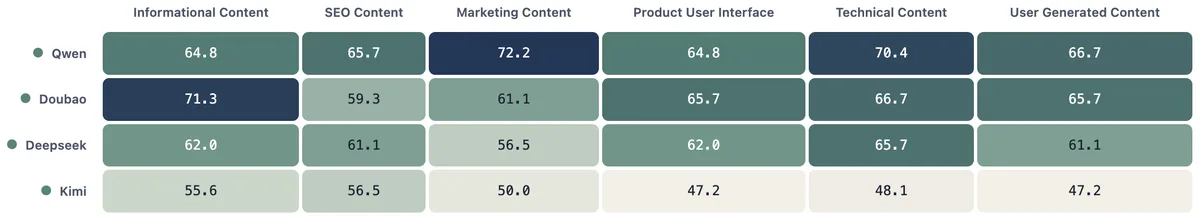
一、人工领先集中在精确度优先的内容,SEO 上优势仅为 2.8 分
先把最容易误读的一条说清楚:专业人工本地化在 6 种内容类型里排第一的有 2 种,另外 4 种排在第 7、7、9、10 名(共 15 个具体工作流参与排名,按并列名次计)。注意,这不等于"AI 全面超越人工"——人工排第 7 到第 10,意思是前面有 6 到 9 个工作流排在它前面,但后面也还有工作流排在它后面。更准确的说法是:在部分内容类型上,最好的 AI 工作流超过了人工。
从目前披露的信息看,人工领先的是 SEO 和资讯类这类重精确度的内容——事实精确度和术语一致性占主导、创作空间几乎为零的场景。比如 SEO 内容(meta description、标题、承载关键词的正文),人工得 74.1 分(满分 100),仍排第一,但只比最好的 AI 工作流高 2.8 分。而营销内容上,人工排第 10/15,比最好的 AI 工作流(经译后编辑的 Qwen)低 22.2 分。这里要特别区分:这个 22.2 是"人工比 PE-Qwen 低"的分差,跟后面会说到的"四个中国模型内部在营销内容上相差 22.2 分"是两个不同的数字,只是恰好相等。研究方对营销结果有一个解读:人工译者似乎会过度修正语言,把文案往正式、规范的方向打磨,反而去掉了营销内容依赖的当下语域。这属于研究方的判断,不是实验测出来的结论。
二、"国产大模型平均 60.7 分"是个不存在的模型
SEO 内容上,人工 74.1 分,未经编辑的中国 LLM 平均分和西方 LLM 平均分都是 60.7,人工领先 13.4 分。很多解读到这里就停了,但作者自己说,13.4 这个数字作为采购依据"几乎没有意义"。为什么?
"中国 LLM:60.7"是 Qwen、Doubao、DeepSeek、Kimi 四个模型的简单平均。这四个模型在 SEO 上的分差是 9.2 分,而 SEO 已经是全研究里差距最小的类别。到了技术内容,同样这四个模型的分差拉到 22.3 分,从 Qwen 的 70.4 到 Kimi 的 48.1;营销内容上的分差是 22.2 分。对比一下西方模型:GPT(生成式预训练大模型) 和 Gemini 这两个模型在六种内容里的最大差距只有 8.4 分,出现在资讯类内容。所以作者说,如果你已经统一用 GPT 或 Gemini,"西方 LLM"这个说法还算诚实;但"中国 LLM"不描述任何真实存在的东西——它是一群最好和最差差出二十多分的模型的平均值。实际选型针对的是具体模型,而不是"中国 LLM"这一类别平均值。
还有一个细节值得留意:Kimi 在六种内容里都是中国四模型中的最后一名,去掉它之后,"中国 LLM"的分数会变动 1.3 到 4.9 分,视类别而定——这只是说明平均分对单个模型有多敏感,不是 Kimi 和其他模型的分差。另外,用户生成内容(UGC)上,Gemini 以 67.6 分领先所有原始模型,这是唯一一个西方模型在不做译后编辑时超过全部中国模型的内容类型。当然,这些都是本次测试的结果,不宜据此给某个模型下"好"或"差"的定论。
三、译后编辑不是"加钱就提质"的固定一层
译后编辑(MTPE)常被当成万能药,但这份测试显示,译后编辑的效果会因初稿模型和内容类型而显著不同。全研究最大的单项变动就出现在这里:用户生成内容上,对 Google 翻译输出做一遍译后编辑,从 33.3 分升至 63.9 分。
但反过来,营销内容上对西方 LLM 初稿做译后编辑,效果是 −0.9 分——类别层面的负收益。还有三个模型层面"越改越差"的案例:PE-ChatGPT 在营销内容上 −3.7、PE-Kimi 在营销内容上 −2.8、PE-ChatGPT 在技术内容上 −0.9。注意这个 −0.9 和前面类别层面的 −0.9 是两个不同层面的数字。技术内容上,译后编辑的效果跨度也很大,从 PE-ChatGPT 的 −0.9 到 PE-Qwen 的 +9.3。全研究下来,译后编辑平均提升 5.6 分——这只是平均值,不适用于任何单个模型或类别。作者的结论是:模型选择比要不要做编辑更重要;选 Qwen 还是选 Kimi,比要不要译后编辑影响更大。
四、已有成熟机翻流程的团队,先加译后编辑再评估换平台
如果你现在已有成熟的机器翻译流程,这项结果提供了一个可先行验证的方向。SEO 内容上,经过译后编辑的 Google 机器翻译得 66.7 分,高于原始 Qwen,也高于研究中所有未经编辑的原始模型。这里要小心两个限定:第一,66.7 是"PE-Google MT"、也就是译后编辑之后的分数,不是原始 Google 机器翻译;第二,它超过的是"所有原始模型",不是所有工作流——人工的 74.1 分还是比它高。
所以作者的建议是:如果你已经有一套成熟的机器翻译流程,先在现有流程上增加译后编辑这一层,再评估是否需要更换平台。
五、翻译分数 ≠ 谷歌排名,也 ≠ 有人搜
这一点必须反复强调:这项研究只衡量本地化质量,没有收集任何排名、流量、转化数据。谁都不宜把 22 分或 2.8 分的质量差距说成排名差距。作者也要求读者把全文当作有待验证的假设,而不是已证实的排名效应。公开证据里,Portent 爬取了 756,297 个有排名的页面,未发现可读性与 Google 排名位置之间存在相关性。本文作者同时承认,对服务商以自身研究论证内容质量价值的循环论证批评,也适用于这项由 EC Innovations 与 Jademond Digital 联合开展的研究。
对做外贸多语种站的人来说,比"翻得对不对"更前置的问题是"有没有人这么搜"。把英文关键词直译成小语种,词本身可能没错,但当地人不这么搜。翻译质量不能替代关键词研究;目标市场的实际搜索需求需要另行验证,相关思路可参考AI 搜索优化指南。关键词需求、收录、流量和转化需要另行验证,可以交给谷歌SEO代运营团队一起做。另外,AI 搜索里的多语种引用问题也值得单独关注一下,我们之前写过一篇百度 AI 引用的分析,可以一并看看。
关于百度,据文章所述,百度更看重域名历史、ICP 备案状态和托管地理位置,而不是页面层面的语言质量。也就是说,一个 ICP 备案加上内地或香港托管,对可见度的帮助可能比 60.7 和 74.1 这两个翻译分数之间的差别还大。当然,这一段的原始出处本身有句子残缺和链接缺失,具体结论按"据报道"看待即可。
六、反方向照着做:外贸团队如何设计自己的对比测试
最后,也是最重要的一点:这份测试测的是英译中,评分人是中文母语者;而不少外贸团队面对的是从中文或英文到其他目标语言的本地化任务。所以只能借方法,不能照搬结论。
作者的建议本身可以作为分流参考:对旗舰 SEO 和资讯内容,可对比人工翻译与经译后编辑的 Qwen / Doubao,再按成本和周期选择;对营销、UI、技术、社交内容,他认为不必再为人工翻译付费。营销、UI、技术和社交内容中,PE-Qwen 均领先或并列领先。放在全部六类内容中看,PE-Qwen 独赢三类、并列第一一类,其余两类排第二。
实际选型前,仍应使用自己的内容和目标语种复测。具体怎么设计一轮对比测试,可以这样考虑:
- 先按内容类型分流。对旗舰 SEO 和资讯内容,可对比人工翻译与经译后编辑的 Qwen/Doubao,再按成本和周期选择;营销文案、社媒内容要特别警惕把语气改得太规范、太书面。
- 多准备几个模型,别按"类别平均分"选。同一个"国产大模型",内部差距在技术内容上能到 22.3 分。
- 用自己的内容和真实目标语种测。不要拿这份英译中测试的分数直接给德语、西语、阿拉伯语排座次。
- 译后编辑当成一个变量,而不是默认动作。先测它在你这类内容上是加分还是减分,再决定要不要固化进流程。
测试之后还有个容易被忽略的环节:多语种内容做完,要在网站上按 SEO 规范落地,并用收录、流量和访客轨迹数据持续调整,而不是翻译完上线就结束。这件事得从建站阶段就打好基础——多语种站点要按 SEO 规范搭好语言版本和结构,这方面可以了解下外贸建站服务。
准备上多语种站点,但拿不准哪些内容可以交给 AI、哪些词当地人真的会搜?可以与我们沟通你的目标市场和语种,一起梳理可行的评估方式。