2026-11-03 更新:本文 2026-09-29 发布时,只能谨慎地说报告"似乎不提供查询级数据"。据 Google 最新公开表态与英国 CMA 规则,无点击、无点击率、无查询已是确定现状,补数据仍无时间表。本文新增一节讲 12 月 3 日英国期限,原有四步自算方法不变。
Search Console 生成式AI报告上线后,很多外贸站的朋友第一反应是"终于能看到自己在 AI 里露了多少脸了",第二反应是——然后呢?曝光是有了,可点击在哪、询盘会不会被截走,报告里一个字都没提。这篇文章不重复吐槽报告本身的缺陷,而是给你一套能动手算的方法:把 AI 可见度、自然搜索依赖度、商业价值等数据结合起来;有可靠数据时,再加入 AI Overview 出现率和日志分析,按栏目算出"商业暴露度",用来辅助确定分析和应对的优先级。这份报告本身的局限,我们在《AI Overviews 更多链接的观察》里拆过,这篇只讲怎么用它。
Search Console 生成式AI报告能看什么、看不到什么
先说能看的:AI 曝光。有说法指出,展示的计数规则是——如果链接出现在 AI Overviews 或 AI Mode 里,就算一次展示;直接显示出来的链接可以计入,而需要用户点开才出现的链接,要等用户真的点开之后才计。作者对这条规则的评价是"其实没多大帮助",因为口径太绕,你很难判断一个曝光到底意味着什么。需要补充的是,这份曝光是 AI Overviews 与 AI Mode 的合并计数,可按页面、国家、设备、日期拆分,该报告已于 2026-08-31 向全球所有站点推出。
再说看不到的:点击数据没有。作者用一段虚构的调侃电话,打趣报告缺少点击数据。据现在已明确的报告口径,点击、点击率、查询三样都没有,这一点不再是推测。还要注意,AI 点击并非不存在,而是被并入标准效果报告的网页结果总数里、无法单独拆出,标准报告的搜索外观类型也没有 AI Overviews 和 AI Mode 的维度。
但别急着把报告打入冷宫。作者的态度很明确:他不认为这份报告没用,恰恰相反,它"差一点就有用"。它是第一方可见度数据,而且是在可以说是全球使用量最大的 AI 界面里拿到的第一方数据。问题不在于它没用,而在于它只做了一半——点击数据就算给你,也只能解决一半问题。
补点击数据仍无时间表:12 月 3 日英国期限意味着什么
先看 Google 自己的说法。Gary Illyes 在 LinkedIn 回应称,团队"非常有兴趣提供更多有意义的数据",但对在 Search Console 补 AI Mode 和 AI Overviews 的点击与查询数据"暂无任何可宣布",也没有给出时间表。这里要特别提醒一句:网传一条署名不明、据称出自 2026-10-30 班加罗尔 Search Central Live 的帖子,说点击与查询是站长最想要的数据、连 Google 自己也不知道何时上线,Illyes 已回应"我不认为我们是这样表述的"——所以别把网传的话当成 Google 的承诺。John Mueller 在 Bluesky 补充说,Search Console 之外还有很多有用数据,"什么算有用"会随时间变化,这句可以当作方向参考,但同样不是时间表。
回到现状:生成式 AI 效果报告只统计 AI Overviews 与 AI Mode 的合并曝光,可按页面、国家、设备、日期拆分,不含点击、点击率与查询。所以在点击数据补齐之前,AI 搜索监测只能围绕曝光搭建,不要把标准报告里的网页点击当成 AI 点击汇报,也不要把两份报告的数字相加——AI 数据本已含在网页结果总数内,相加只会重复计算。
真正带期限的推手来自英国。英国竞争与市场管理局(CMA)的出版商规则,是一份官方文件,经 assets.publishing.service.gov.uk 发布,对 AI 功能提出了明确的指标与提供方式要求:
- 指标须包含曝光、点击、点击率;
- 按 AI 功能汇总;
- 能按单个出版商拆分;
- 能区分内容出现在 AI 功能还是自然结果;
- 须通过 Search Console 这类常用平台提供;
- 合规期限为 2026-12-03。
还有两个时间点要记下:页面级 AI 功能控制在 2026-12-03 期限后三个月到期;Google 首份合规报告覆盖 2026-06-03 至 12-03,须于 2027-01-03 前提交,CMA 预计另发通知要求公开其摘要版。需要说清楚的是,这套规则直接约束的是面向英国用户展示的 AI 功能,是目前唯一带期限的硬节点,不宜理解成全球同步生效。
对外贸企业来说,等待期里也能把功课做在前面,以下几条建议供参考:
- 月报固定四列:AI 合并曝光(按页面、国家、设备、日期);同页面的标准报告网页点击,并明确标注含 AI 与自然、不可拆;GA4 的自然会话与询盘;备注栏记录口径变化。每月同日、同 property、同日期窗导出,保证可比。
- 现在起按月存档曝光基线,12 月 3 日前至少留一个月基线;期限前后各复查一次报告有没有新增点击、点击率、查询维度。
- 2027-01-03 前留意合规报告摘要版;页面级控制到期时,再复查一次控制粒度是否变化。
只看曝光为什么不够:外贸站真正该问的是"询盘会不会被截走"
要看清真实风险,光有曝光不够,光有点击也不够。你还得知道:你的流量和商业价值,被 AI 系统截走了多少。这就是为什么我们需要把几层数据叠起来用。
对一般站点来说,基础分析需要 GSC 和 GA4(或者你自己用的分析平台),再加上商业层面的数据(收入、转化、询盘,你自己选);而重要查询的 AI Overview 出现率,则用于 Enhanced 模型。服务器日志可以当作需求的代理指标,但它属于可选项,不是必需品。哪怕你只有 GSC 加 GA4 的受众和商业数据,也能挖出很不错的洞察。
第一步:导出页面数据,按栏目归类
从生成式 AI 报告里把页面数据导出来。这里要留个心眼:页面导出不一定覆盖全部页面或全部展示。具体原因没有进一步说明,但结论是明确的——你拿到的不等于全貌。
导出之后要做的事是按内容板块归类,我们马上要按板块分析可见度。起步阶段按子目录分类就完全够用,比如产品页 /products/、应用页 /applications/、博客 /blog/ 这样分。对大型站点或者多 property 的情况,可以按子目录层级导出报告,再把各个 property 的数据合并起来;小站点基本不受这个问题影响。
还有一个动作别忘:算一下你这份页面级数据,占 Google 报告的总可见度是多少。因为导出有 1,000 行的上限,一旦超过这个行数,你看到的就只是样本,不是全量。这个 1,000 行说的是导出的行数上限,跟后面要讲的"取前 100 或前 1,000 个查询"完全是两回事,别混。
第二步:看 AI 曝光集中在哪里
有了页面级数据,就能回答几个很实在的问题:可归因的 AI 可见度集中在哪?哪些板块和 URL 出现在数据集里?这些可见度是均匀铺开的,还是集中在少数几个"表现好"的页面上?我们这份页面级数据,又占 Google 报告总可见度的多少?
把 AI 曝光的分布画出来,检查可见度是均匀分布,还是集中在少数 URL。这本身就是个信号:如果可见度集中在少数页面,还要结合这些页面对应的商业价值和搜索依赖度,才能判断风险高低。要判断真实风险,不能只看页面的类型。
另外,AI 展示的涨跌趋势可以直接在 GSC 里看,往上还是往下,时间维度上的变化不用自己算。
第三步:给每个栏目配上商业价值
现在我们知道了 AI 曝光在哪,但这到底对生意意味着什么?得配上商业数据。
做法是选一个主商业 KPI——收入、订阅、转化、询盘、线索,你选一个——然后每个子目录都用同一个。具体选哪个指标不重要,前提是它能代表业务价值,而且你从头到尾用得一致。注册数、订阅倾向、广告收益这类次要指标,可以叠加进来当辅助背景,但别喧宾夺主。
作者在这里特别提醒了一句:别把这件事搞复杂。他自己那套方法改了十次以上,改到头发都比开始时白了。
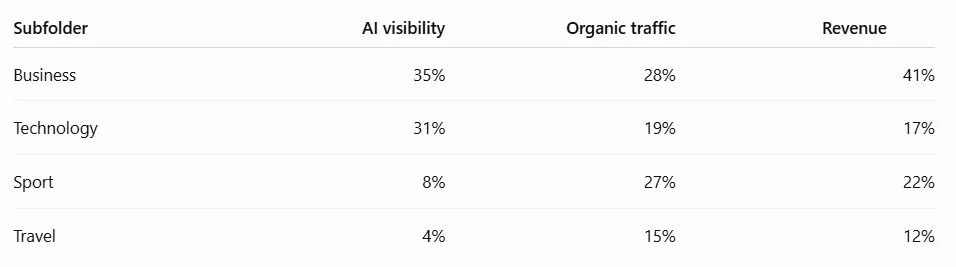
配好之后就能做对比了。报道中举了个示意:Business 板块 AI 可见度高,但收入也更高;Technology 可见度和它差不多,收入却明显少得多;Sport 可见度很低,却贡献了更大比例的收入。注意这只是示意说明,没有给具体数字。
还有一块是搜索依赖度,也就是总会话里来自自然搜索的比例。道理很直白:比如一个只有 10% 流量来自 Google 的站点或子目录,风险低于 90% 流量都靠 Google 的——尤其是当它大部分流量是直接访问或品牌流量的时候。这里的 10% 和 90% 是作者举的假设对比,不是调研数据。
第四步(可选):补上 AI Overview 出现率和服务器日志
这一步是增强项,不是必需项。没有它你照样能算商业暴露度,有它会更细。
先说 AI Overview 出现率。这需要第三方 SERP 数据。查询样本怎么取?每个站点或板块取 GSC 前 100 或前 1,000 个查询,作为起点完全合理。
这里有个关键认知必须说清楚:这个数据只能告诉你"曝光处在 AI 环境里",它证明不了点击被替代。这项数据本身不能证明点击被替代。所以它反映的只是当前搜索环境中的暴露程度,不是流量损失的估算。
如果想持续监测核心词的 AI 结果变化,可以参考 AI Mode 监测与告警的搭法。
再说服务器日志。日志能告诉你哪些板块和 URL 被访问、是哪一类 AI 爬虫在发请求。不同爬虫干的活不一样,所以不要笼统归为"AI 流量",而要分开看:它反映的是发现、模型访问、用户触发检索这几类不同需求。
但有个底线必须守住:日志只能证明访问,不能证明被用于训练。一个训练爬虫抓了某个 URL,并不能证明这个内容被用来训练了模型。我们能下的结论最多到这一步——"这个内容吸引了与训练、搜索和/或检索访问相一致的 AI 爬虫活动"。日志要发挥作用,得按子目录和爬虫类型汇总。
最后一条实操纪律:没有可靠的 AI Overview 数据时,留空,不要填 0。因为 0 表示"在所选查询样本和观测时段内,未观测到 AI Overview",这与"没有可靠数据"不同,也不能据此判断点击是否被替代。这种情况就改用 Core 模型。
把几项数据合成"商业暴露度",排出优先级
作者把可见度、搜索依赖度、商业价值等输入合在一起,算出一个商业暴露度,衡量每个板块对自然搜索的依赖和风险。工作簿里把这些数值都归一化到 0–100,作者也建议你这么做,图个简单。
模型分两版:Core 版和 Enhanced 版。Enhanced 版包含 AI Overview 数据,还需要做少量服务器日志分析。如果你有 AI Overview 数据,可以算 Enhanced;没有就用 Core。还配了可选的 AI Opportunity 分析(基于服务器日志),以及一张比较各内容板块的最终记分卡。
合成的时候有两条原则,非常关键:
- AI 可见度很高、但商业价值几乎为零的内容,暴露分不应该高。曝光多不代表丢钱多。
- 反过来,价值很高、但 AI 可见度低或者搜索依赖有限的内容,也不一定是高风险。
光算出暴露度还不够,因为同样暴露度的两个板块,实际风险可能差很多。所以还得看韧性,四项:品牌搜索量、直接访问、回访受众、内容可防御性。前三项可以用百分比表示;内容可防御性需要人工判断,按 1–5 分制打分,再换算到与其他指标一致的百分制。可防御性看什么?独特性、投入程度、专业度、专有信息、获取难度。公式是四项相加除以 4,分数越高,这个板块越能抵御 AI 进一步的搜索替代或中介化。
高暴露板块的应对思路,一是加强品牌词、直接访问和老客回访,把不依赖搜索的入口做厚;二是做别人抄不走的内容。这也是谷歌 SEO(搜索引擎优化) 长期运营中需要持续建设的部分,可参考我们的谷歌SEO服务。
还有第三条路值得走。除了评估现有风险,也可以研究如何提升内容在生成式搜索中的可见度。想了解相关路径,可以查看我们的GEO 生成式引擎优化。
最后是 AI 机会这一层。把日志数据映射到页面和子目录后,可以对比"AI 需求"和"内容价值"。高价值的专有内容被检索爬虫大量抓取,可能是机会,可能是负担,也可能两者都是——在做授权、投资、合作、AI 分发这些决策之前,你应该先知道这件事。但请记住:爬虫活动本身不会让内容变得有价值。
整篇方法其实围绕一个问题:AI 在哪里对现有生意构成威胁,又在哪里可能为你已经在产出的价值打开一个新市场。作者最后说了一句话,我觉得挺对:作者认为,SEO 从业者比其他角色更适合帮助企业理解内容的价值。
不确定自己网站哪些栏目的 AI 商业暴露更高?给我们留言,说说你的网站和主要市场,我们帮你看看从哪里开始算这笔账。AI 搜索还在从一次查询变成持续任务,AI Mode 信息监控的最新变化也值得一并留意。
参考资料
- The Generative AI Report Sucks – Let's Make It Brilliant(Search Engine Journal)
- Google Search Console 官方介绍
- Google Says No AI Click Reporting News Yet, Ahead Of UK Deadline(Search Engine Journal)
- 英国竞争与市场管理局(CMA)出版商规则官方摘要与解释性说明(官方文件,经 assets.publishing.service.gov.uk 发布)