先说结论:llms.txt 在多方实测下基本无效,别把它当 GEO(生成式引擎优化) 策略。给 AI 看的这份"精选目录",现在最多花约 1 小时顺手放一个,放完就走,不要指望它带来 AI 引用,更不要写进方案里对客户承诺效果。这个判断比一年前"低成本实验、不指望效果"更进了一步——不是"还没看到效果",而是"多组实测里基本没效果,其中正式测试包含对照"。与此同时,另一条路的实测胜率反而更值得外贸企业关注:做一张 AI 信息页。下面把证据、边界和具体动作一次讲清楚。
llms.txt 是什么:给 AI 的一份"网站精选目录"
按照官方规范网站 llmstxt.org 的说法,llms.txt 是一项"提议中的标准",目的是帮助大语言模型更好地理解和使用网站内容。核心思路很直白:与其让 AI 爬虫在你网站里到处乱转,不如主动给它一份精选的最重要内容清单。
它和我们熟悉的 robots.txt、sitemap.xml 不是一回事。与 robots.txt 和 sitemap 相比,llms.txt 专门面向可能使用网站内容回答问题或生成回复的 AI 模型。
这里要先泼一盆冷水:目前没有任何证据表明它能提升你在 AI 回答中的曝光度,也谈不上带来引荐流量。市面上确实有这类猜测,但截至目前只是猜测——而且随着测试数据积累,这个猜测越来越站不住。
约 14 个月增长约 17.5 倍:谁在加 llms.txt?
采用量的增长是真的。2025 年 7 月,全球只有 951 个域名发布了 llms.txt;据 NerdyData 数据,截至 2026 年 9 月,这个数字来到了 16,670 个,大约 14 个月增长约 17.5 倍。对一个 2024 年 9 月提出的规范来说,这个速度不算慢。
但把镜头拉远:16,670 个域名,放在数亿个活跃网站里仍然只占很小比例。增长的曲线是真的,但窗口还很宽——从采用率看,目前发布者仍属少数。
想看别人怎么写的,有个简单办法:在任意域名后加 /llms.txt 就能打开该站的文件。几个常见例子可以感受一下风格差异:Hugging Face 像一个完整的开发者文档库,多级标题、完整代码示例、大量链接;Vercel 顶部有描述行(title:、description:、tags:),标题清晰,有分步说明和实用代码示例;Zapier 结构很简单,主要是一长串带描述的链接;Cal.com 则是顶部标题之后,直接进入分组链接列表。
不只是 Semrush 一家:Seer 的对照测试里也没人来读
过去我们引用比较多的是 Semrush 自己的单站测试:2025 年 3 月,他们在姊妹站 Search Engine Land 上部署了 llms.txt,随后分析服务器日志,日志分析时间段为 2025 年 8 月中旬至 10 月下旬。结论是部署 llms.txt 与 AI 结果中的表现提升之间没有相关性。更直接的数据是,llms.txt 这个页面收到来自 Google-Extended、GPTBot、PerplexityBot、ClaudeBot 的访问次数为零;而传统爬虫 Googlebot 和 Bingbot 只访问了几次,也没有特别重视这个文件。这里要分清楚:零访问指的是那四个 AI 相关爬虫,Googlebot 和 Bingbot 并非零访问,只是次数很少。当然,这只是单一站点、单次实验的结果。
单一站点的说服力有限,所以更有价值的是行业机构 Seer Interactive 的多客户对照测试。截至 2026 年 10 月 5 日,他们的测试库里已有 70 个已完成的 GEO 测试,覆盖 17 家客户。关于 llms.txt,正式客户测试的战绩是 0 胜 2 负;如果算上"同一客户同一天上线 llms.txt 和 AI 信息页"的双发对照,则是 0 胜 3 负。这两个口径要分开看,但方向一致:没有一次赢。
日志层面的细节更能说明问题。两家正式测试客户的服务器日志里,ChatGPT 对 llms.txt 这个文件的请求数为零;在合计 9 家客户中,各类智能体对该文件的请求也极少,对引用表现的影响可以忽略。放到更大的样本里看:约 920 万条 AI 回答、覆盖 100 个客户数据集,其中只有 73 条引用了 llms.txt 文件本身的 URL,而且多为开发者文档;这 73 条里还有 15 条是 Gemini 在给 GEO 建议时虚构出来的 yourdomain.com/llms.txt 这类链接——不是真被读取,是被模型"编"出来的。
外部佐证方向相同。Ahrefs 的统计显示,约 3.8 万个带有有效 llms.txt 文件的站点中,2026 年 5 月有 97% 没收到过针对该文件的任何请求;另有约 30 万域名的研究未见该文件对 AI 引用有明确作用。Google 官方也说得直白:Google Search(含其生成式 AI 功能)不使用这类文件,为其他服务维护 llms.txt 完全可以,但"既不会伤害也不会帮助"你在 Google Search 中的可见度或排名。注意这个口径只限 Google Search,不能外推成所有平台的政策;它也和 Mueller 的个人表态是两回事。
信号为什么这么混乱:Lighthouse 检查它、Anthropic 自己也放了
你可能会问:既然没人用,为什么到处都能看到相关信号?因为这些信号大多被误读了。
第一个信号:Google 在 Lighthouse 中新增了实验性的 Agentic Browsing 类别,其中一项检查会查找 llms.txt。这看上去很像"Google 官方背书",但 Lighthouse 审计和实时抓取是两套独立系统,检查项的存在不是 Google 爬虫使用该文件的证据,它也不是 Lighthouse 的正式评分项。
第二个信号:Anthropic 在自己的网站上发布了 llms.txt。这或许说明他们至少对这个想法持开放态度,但不代表它的爬虫会用这类文件——Claude 依然在"未确认读取"的平台之列。
第三个信号:Google 发布了 Open Knowledge Format(OKF),当前版本 v0.1,是一个为 AI agent 打包内容的开放规范。这里千万别理解成"Google 用 OKF 取代 llms.txt"。两者的方向刚好相反:llms.txt 面向访问你网站的外部爬虫,OKF 面向组织自己的内部 agent,不是替代关系。
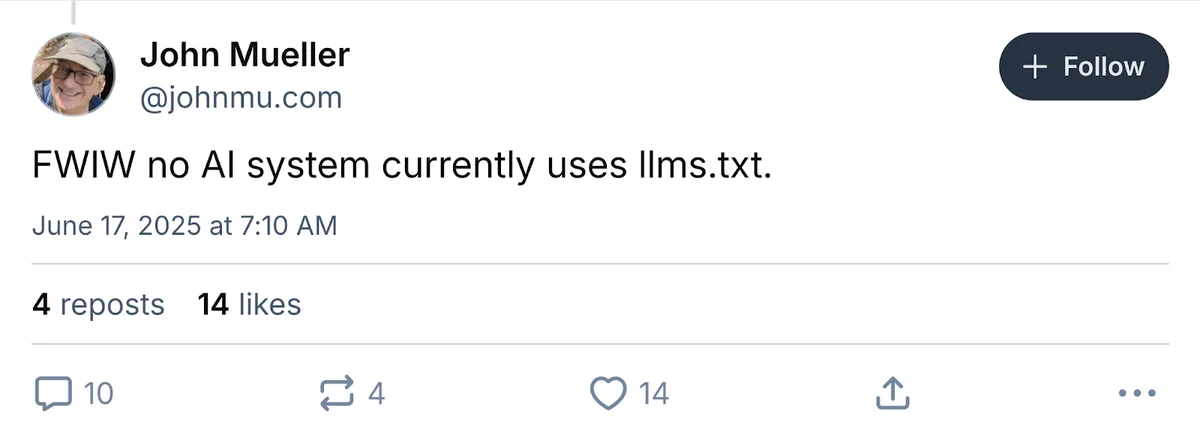
还有一层混乱来自从业者的个人表态。据报道,Google 的 John Mueller 曾于 2025 年 6 月在 Bluesky 上表示 AI 系统不使用 llms.txt。这是个人口径,不是官方政策文件,但和后来官方文档的说法方向一致。
llms.txt 怎么写:格式与外贸站示例结构
如果你还是想放一个,实施成本确实低,照着下面做、放完就走,别在这上面反复打磨。
文件用 Markdown 格式编写,保存为小写的 llms.txt,这是官方规范使用的文件名。常见结构是:一个 H1 写站点或产品名,一个可选的引用块描述,然后一个或多个 H2 分组,每组是带链接的列表项,链接后面可以用冒号加一句描述。大型或复杂网站还可以使用 H3、H4、表格和代码片段。
放置位置分两种:覆盖全站就放在根目录(yourdomain.com/llms.txt);只想覆盖文档,也可以放在 /docs/llms.txt 等子路径,或放在子域名(如 docs.)下,文档范围不限于子域名。上传一般通过主机控制面板完成,上传后直接访问该 URL 验证即可。
外贸 B2B 站该放哪些页面?建议优先放产品或服务页、较新的博客文章、价格页、关于我们和联系页。原则是选常青的规范内容,跳过个性化页面、需要登录的页面、重复页面和很快过时的内容。下面是一个只用于演示的结构,公司名和域名都是虚构的:
- H1:示例公司 Example Co., Ltd.
- 引用块:一句话说明主营品类与目标市场
- H2 产品线:下面用列表列出各产品页链接,冒号后写一句描述
- H2 公司与支持:关于我们、联系页、价格页
顺手提一句:新建外贸独立站时,可以把它放进 建站 交付清单,一次做完省得回头补。如果已经有 AI 信息页,也可以在文件里链过去,权当多个入口。
AI 信息页是什么:为什么它和 llms.txt 不是一回事
AI 信息页听起来玄,其实很朴素:它就是一张普通的 HTML 网页,集中写清"你是谁、做什么、有哪些关键事实、网上流传的哪些信息需要纠正",专门方便 AI 在回答关于你的问题时现场抓取核对。它没有任何官方规范,不需要特殊文件名,也不是机器专用格式。
它和 llms.txt 的根本差别在于工作路径。AI 系统回答问题,主要靠索引检索和实时抓取网页内容,普通 HTML 网页正好落在这条路径上,可以沿常规检索与实时抓取路径被发现,但仍须用日志确认是否被抓取。本文讨论的是 GEO 效果,不能据此否定开发者工具主动读取文件的用途。而 llms.txt 是一个额外文件,需要爬虫专门来读它,而多组日志显示它们并不来。一个在主干道上,一个在没人走的小路上。
AI 信息页的实测:4 家测试客户里 3 家见效
Seer 在同一批客户身上测了 AI 信息页,结果明显好于 llms.txt,4 家测试客户中 3 家见效。
一家能源科技公司上线约一个月后,被追踪的 57 条事实中有 21 条(37%)出现在了 ChatGPT 的回答里;其中受众和行业表述最容易被采纳,自有产品名反而最不容易。一家企业数据保护软件公司与 llms.txt 同日上线,Gemini 和 Perplexity 引用了信息页、却从未引用那个文件——不过这是早期读数,时间约 3 周、约 10 条回答,样本很小,别当定论。一家应收账款软件公司则由客户团队自评为胜。
库外追踪里还有两组数据。一家金融数据公司的信息页收到 439 次 ChatGPT-User 请求,占其全部请求的 74%;ChatGPT-User 是真人提问触发的实时抓取,这个量级说明页面确实在被用。另外抽了 10 条品牌回答样本,约一半采纳了页面用语,但多为部分匹配——这里衡量的是用语采纳,不能等同于页面引用。Seer 自家的信息页于 2025 年 10 月上线,固定问"Tell me about Seer Interactive",全年平均约一半回答引用了它:403 条样本、两个时段分别是 50.4%(2025 年 11 月末至 2026 年 3 月)和 52.5%(2026 年 6 月至 9 月)。
这些结果仍有局限:AI 信息页的这些胜场没有对照组,且多为单平台读数,Seer 作者自评方向上只有"中等信心"。相比之下,llms.txt 那个"基本无效"的结论证据更受控(有子目录对照加服务器日志,单测上线后数据仅 2–3 周),作者信心也高。所以正确的读法是:llms.txt 别当策略是稳的;AI 信息页值得试,但不是必胜。
更适合回答"你是谁",对采购决策问题的作用有限
AI 信息页能稳住的是"你是谁"类问题——公司做什么、产品叫什么、哪些事实是对的。它对"该不该雇你"这类带买家角色与问题背景的提示词的作用正在衰减:41 条带买家角色与问题背景的提示词的引用率在 2026 年初夏降到了 7.8%,此后大致在 5%–13% 区间波动;普通品牌提示词也从 57% 一路滑到接近 30%。这不是"完全无效",但也说明它不是一劳永逸的资产,需要定期维护;引用率下降本身也不能直接证明维护就能恢复效果。
失败案例:页面没被抓取,写得再好也没用
那 4 家里失败的一家是通信 SaaS 公司。它的 AI 信息页 Markdown 版在最后一周零 AI 爬虫请求,30 条事实只命中 1 条;2026 年 1 月改成 HTML 重新发布,仍然是 0/30。改格式没用,因为智能体根本没来抓。
这个案例给了一条很硬的推论:先查日志有没有抓取,再谈内容。所有有效案例用的都是 HTML,但 HTML 不是充分条件——页面不被抓,写得多好都等于没测。至于怎么从服务器日志里确认 AI 爬虫到底来没来、抓没抓到,我们在服务器日志分析里讲过字段、分层和验真方法,这次直接落到动作上。
怎么做:先做信息页,llms.txt 最多顺手放
给外贸企业老板和市场负责人的操作顺序是这样,四步走。
- 第一步,先查日志再动手。上线前先检查现有页面与抓取基线:拟建 URL 尚未上线,其历史零请求不能作为抓取失败证据。信息页上线后,按周统计目标 URL 的请求数和 200 占比;导出近 4 周服务器或 CDN 日志,筛出 ChatGPT-User、PerplexityBot、OAI-SearchBot 对 /llms.txt 和已上线页面的请求数与 200 状态占比。如果零请求,先查入口问题:页脚有没有链接、在不在 sitemap、robots 有没有误拦、正文是不是靠 JS 渲染。这些没排掉之前,不要先改文案。
- 第二步,建一张 HTML 信息页。干净 URL、返回 200、没有 noindex、正文不依赖 JS 渲染。内容怎么定?先跑一轮品牌提示词,记下 AI 说你错在哪、漏了什么;然后用买家用语写平实事实,数字带上日期,该纠正的写明。做完挂到页脚、加进 sitemap,让爬虫找得到。
- 第三步,llms.txt 最多花约 1 小时。已有的就留着,顺手在里面链向信息页;没有也不必专门立项。它不进 GEO 策略,不对客户承诺效果。
- 第四步,按节奏验收。上线后 4 周做初判、12 周下结论,看品牌提示词里信息页的用语被采纳的比例;每季度刷新一次信息页上的事实和数字。
比文件更确定的事:让 AI 真正拿到你的内容
与其纠结一个实测基本无效的文件,不如把力气花在更确定的基础动作上。
第一,让页面本身容易被读懂。据 Semrush 介绍,多数 AI 爬虫只能读取页面的基础 HTML,读不到 JavaScript 加载的内容。如果你的核心信息都靠脚本渲染,那么无论有没有 llms.txt,AI 都可能看不到。关于页面结构如何影响机器读取,另见纯文本网站与机器可读性的讨论。
第二,把内容写得更清晰。清晰、直接的内容通常更便于机器理解。与其多写一个文件,不如在产品页开头直接回答买家的核心问题,把 H2 写成买家会问的问题,比如"这款产品的 MOQ 是多少""交期多久"。完整的做法见 AI 搜索优化指南。如果想系统地排查网站在 AI 答案里的可见度,可以了解我们的 GEO / AI 搜索优化服务。
不确定你的外贸网站有没有被 AI 爬虫正常抓取、要不要加 llms.txt?给我们留言,联系我们讨论网站的基础抓取与内容配置。