个人 AI 智能体正在成为外贸网站访客里最陌生的一类人。它不自报家门,你也认不出它,但它确实会打开你的产品页、点开询盘表单、试着把一件事办完。Meta 的 Muse 和 OpenAI 的 Dots 是这一类东西的代表:它们不再只是回答问题的聊天框,而是替用户动手的"代客操作员"。对做外贸独立站的企业来说,问题不在于 AI 会不会提到你,而在于它作为一个顾客走到你网站上时,能不能把你的询盘、索样、报价按钮按下去。
两种商家:有连接器的,和被智能体"当顾客走一遍"的
这批智能体把商家分成两层。第一层是有连接器的:Muse 上线时已经有数十家合作方接入,并打通了整个 Shopify 商品目录,还在陆续新增大型零售商;Dots 则靠几千个应用插件生态连接。对这些商家,智能体走的是接口,挑货、下单、付款都在应用内完成,网站从头到尾没被打开过。
第二层没有连接器,智能体只能开一个云端的真实浏览器,像人一样把你的网站逛一遍。Shopify 的默认设置会把店铺自动纳入 AI 购物渠道,那个默认开启的开关,我们在 Shopify 默认把店铺接入 AI 购物渠道 一文里拆过。据该文报道,Shopify 于 2026 年 8 月 5 日为使用 Liquid 构建的店铺默认启用 WebMCP 工具,包括商品搜索、购物车、结账和政策查询。这些都是在平台层完成的。
自建站没有这层照顾,默认就落在第二层。绝大多数 B2B 外贸独立站属于第二层——没有连接器,没有平台替你声明动作,智能体只能靠看你自己的页面来判断能干什么。
你认不出它:没有公开 UA,robots.txt 也写不进名字
第一件让人不适的事实:目前披露的信息显示,Meta 和 OpenAI 都没有公布这类智能体浏览器的 user agent、请求头或 IP 段。Meta 官网上给站长列出的爬虫名单里没有 Muse,OpenAI 的爬虫名单里也没有 Dots。也就是说,你想在 robots.txt 里写一句"此智能体请勿访问",连名字都写不出来。
这不是因为你不会写,而是因为 robots.txt 本身不是访问授权或强制访问控制机制,不能单靠它阻止访问;相关法律后果仍需结合适用法律与具体情形判断。将于 2026 年 10 月 30 日生效的新版 Meta 商业条款保留了相关爬取许可,涉及与商业用户产品或服务关联的网站,条款里没提 robots.txt;Meta 亦表示尊重网站通过 robots.txt 表达的偏好。
Meta 对外的说法是:Muse 浏览时"表现为你的活动",网站分析工具会把它算成一位顾客。Amazon 曾主动封禁 Muse,给出的理由是它未披露身份、身份不明、疑似抓取并存储顾客凭证——注意,这是 Amazon 称,不是已经证实的事实。但这足以说明:放不放行,是个需要你主动做的判断,而不是一个可以交给默认规则的默认值。
它看到的不是你的页面,是无障碍树
据 Search Engine Journal 的报道,Muse 读页面靠的是无障碍树(accessibility tree),不读原始 DOM,不读 JSON-LD。Muse 的浏览子智能体接收无障碍树快照,不能自行在页面上下文执行 JavaScript;网站自身脚本仍会正常运行,生成的内容能否被读取,要看是否进入无障碍树。这几句话只针对 Muse,别推广到所有智能体。
无障碍树里有什么?标题层级、链接文字、图片 alt、HTML 文本里写着的价格和规格、有可访问名称的按钮和表单字段。没有的,就是它看不见的。以下针对 Muse。
- 读得到:标题层级、链接文字、alt 文本、正文里的价格与规格、具有可访问名称的按钮和表单。
- 读不到:原始 DOM、结构化数据、未进入无障碍树的内容。
关于读取方式,Google 在其生成式 AI 搜索优化指南里写的是:浏览器智能体"可能"通过视觉渲染(比如截图)、检查 DOM 结构、解读无障碍树三者结合来获取它需要的数据。这是"可能",不是"确认所有智能体都这么读"。顺带一提,同一份指南明确说不需要 llms.txt 之类的特殊文件,结构化数据对生成式搜索不是必需(对富媒体结果仍有用)。
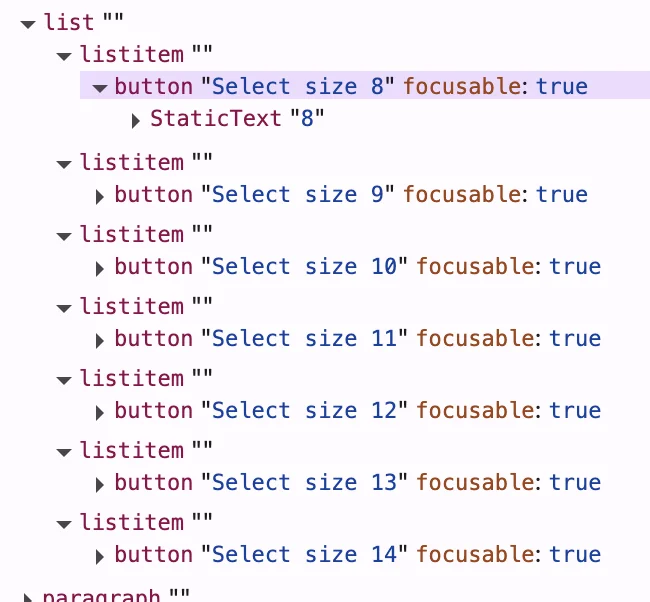
作者在一家大型 Shopify 店铺做了一次实测:产品页的尺码选择器上,人眼能看出"8 码有货,9 到 14 码变灰打叉",但在无障碍树里,那是七个一模一样的按钮,写着"Select size 8"到"Select size 14"——缺货这件事在树里根本不存在,要点下去才弹出"Out of stock"。智能体只能一个个试。你花在设计稿上的那点视觉信息,它一点没收到。
换到外贸站:智能体买的不是货,是"发出一条询盘"
外贸 B2B 的转化动作和零售不一样。智能体不是来凑单的,它是替买家来核验、来发起接触的:填询价表单、申请样品、下载规格书、点 WhatsApp。这些地方要在无障碍树里"存在",标准很朴素。
- 询价表单:每个输入框都要有真正关联的 label,不能只用 placeholder 占位。字段名要写"公司名称""采购数量",不要写"栏位 1"。
- 提交按钮:按钮和链接应具有清晰的可访问名称,优先使用可见文字;使用纯图标时,可通过 aria-label 或 aria-labelledby 等方式提供名称。表单字段优先使用正确关联的 label,并在可访问性面板中核验最终名称。
- 索样 / 下载规格书:用真正的链接和按钮,不要把按钮做成一个没有语义的容器块加一段点击脚本——在无障碍树里它可能压根不是个可操作元素。
- WhatsApp 按钮:按钮和链接应具有清晰的可访问名称,优先使用可见文字;使用纯图标时,可通过 aria-label 或 aria-labelledby 等方式提供名称。
- 公司信息:公司名、联系人、邮箱如果只出现在图片里,且未提供等价文本,对它来说等于不存在。
最后这条值得多说一句。海外买家点开联系页,本质是在一个陌生供应商门口做核验:公司是不是真的、有没有具体的人、渠道能不能联系上。智能体替买家做的也是这套核验,只不过它靠的是按钮名字、链接文字和页面里的文本。如果联系方式只放在图片里,且没有提供等价文本,依赖无障碍树读取页面的智能体可能无法获取这些信息。
还有一个隐患:智能体无法确认提交成功时,可能重复提交。某从业者分享的单一样本显示,两件事会让 AI 智能体提交表单失败——HTML 本身无效,以及表单提交后不返回程序可读的成功或失败结果。该个案中,表单已经提交成功,人能看到确认反馈,但智能体无法读取或确认这一反馈,因此重复提交。换成外贸语境,这就是重复询盘,可能增加 CRM(客户关系管理) 分配和去重的负担,销售还得花时间合并去重。另外,一项让 Claude Sonnet 4.5 computer-use 智能体完成 60 个任务的研究显示,默认条件下成功率 78.3%,只用键盘时降到 41.7%,页面放大到 150% 时降到 28.3%。这些结果提示,应优先检查依赖特定输入方式或缩放条件的交互。
GA 里看到的"顾客",可能不是人
这里有两处分析断层。第一处,智能体在应用内直接下单,订单只留在平台自己的订单记录里,你的网站和像素完全看不到。第二处,智能体走浏览器下单,会被计成一位普通顾客的访问,和真人混在一起。
GA4 在 2026 年 5 月新增的 AI Assistant 渠道,只靠 referrer 识别,能覆盖的是"从 AI 应用里点链接跳过来"这一种情况。就算这一层也统计不全:Gemini 已经开始给外链加 UTM,Google 的 John Mueller 回应说 Gemini 本来就有 referrer,但有从业者反映,referrer 基本只在桌面网页端保得住,移动 App 里透传率大约一成,Android 助手调用会把它整个去掉,大量流量因此落进"直接访问"。AI 带来的流量常被算进"直接访问",参考 Gemini 给外链加 UTM 之后怎么归因。连"从 AI 跳过来"都数不准,更别说智能体自己直接访问你的站了。
llms.txt 和纯文本版帮不上这类智能体
过去两年,很多人给网站做了 llms.txt 和 markdown 纯文本版,思路是让"阅读的机器"读得更顺。问题是,这类智能体不是来读的,是来办事的——而纯文本版恰好把按钮、表单、结账这些动作全删掉了。为什么给 AI 准备纯文本版反而丢了关键一层,详见 网站的纯文本版本剥掉了错误的一层。
把 AI 获取信息的方式拆开看有三条路:靠记忆、现场查网页、直接调用工具。前两条决定它会不会提到你,个人智能体走的是第三条加浏览器,决定的是它能不能替客户把事办完。这也是我们说 GEO(生成式引擎优化) / AI 搜索优化解决被引用的问题、可操作性是下一层的原因。
作者把这套完整图景叫"机器优先架构",分四块:身份、结构、内容、交互。本文讨论的 GEO 重点是内容被引用;控件语义与任务完成还需要 SEO(搜索引擎优化)、前端和无障碍工作共同参与。
给老板的四个决定,和一份外贸站自查清单
四个决定,换成外贸语境:
- 团队:让 SEO 和前端一起做行动页(询盘、索样、注册、下载),SEO 还要参与 bot 防护规则的评审。
- 风险:主动决定放不放行智能体,别让默认的爬虫规则把顾客的智能体挡在门外;放行不等于撤掉表单防刷和限流,两件事分开做。据 Anthropic 自行披露,Claude 在内部评估中提交过真实的公开表单、利用访客可领取的 token 绕过网站限制——这就是为什么防护要留,只是别误伤。
- 预算:先给询盘页修无障碍。WebAIM 2026 对全球访问量前一百万网站首页的检测中,95.9% 存在 WCAG 2 失败项,比上一年的 94.8% 还升了,每页平均 56.1 个错误。最常见的几类里,表单输入框没有 label 占 51%,空链接 46.3%,空按钮 30.6%——这三类恰好都是让"动作"消失的那一种。
- 机会:智能体在十家店之间比价时,它只能从自己能操作的店里买。这是条件句,不是承诺——Meta 和 OpenAI 都没披露排序逻辑,没有哪家厂商公布过智能体带来的订单量和转化率。无障碍做得好,不等于会被优先推荐;但做不好,可能使智能体无法完成操作。
再说自查。建站验收别只看设计稿还原得像不像。表单的 label、按钮的名字、提交后的成功或失败提示,都应该写进开发验收项。设计定稿后由程序员一比一还原、并按 SEO 规范开发的站,这一步最好在模板层一次做对。把表单语义和提交反馈写进 外贸建站 的验收标准,比事后一个个页面补要省得多。
怎么做
三条能这周就安排下去的动作:
- 拿核心询盘页做一次语义检查。在浏览器开发者工具的可访问性面板中,逐项检查控件的角色、名称和状态,再用键盘完成一次询盘流程。关闭 CSS 和图片可以作为补充检查:确认每个输入框都有 label、控件都有可访问名称、每个索样和下载入口都是真正的链接或按钮。按钮和链接应具有清晰的可访问名称,优先使用可见文字;使用纯图标时,可通过 aria-label 或 aria-labelledby 等方式提供名称。表单字段优先使用正确关联的 label,并在可访问性面板中核验最终名称。看不见名字的按钮,智能体分不清它和旁边那个有什么区别。
- 给表单提交加一个机器能读的结果。提交成功后返回明确的文字提示,失败时也返回具体原因,别只做一个淡出的动画。这一步有助于降低因反馈不清导致的重复提交风险,并有助于降低 CRM 中出现重复记录的风险。
- 把你的 bot 防护规则过一遍。看清楚现在的规则会不会把正常浏览器行为的智能体一并拦掉,也看清楚放行之后表单防刷还在不在。这是一次权衡,不是一道是非题。做完之后,可以让技术按无障碍树的视角把首页和核心询盘页再走一遍。
想知道 AI 智能体打开你的询盘页时,看到的是一个能填的表单,还是一排没名字的按钮?给我们留言,我们帮你按无障碍树的视角把首页和核心询盘页过一遍。
参考资料
- Search Engine Journal,《What Personal AI Agents Like Meta Muse And OpenAI Dots Mean For SEO》,2026-10-20:https://www.searchenginejournal.com/personal-ai-agents-meta-muse-openai-dots-seo/592530/
- Search Engine Journal,《The Text-Only Version Of Your Website Strips Out The Wrong Layer》,2026-09-25:https://www.searchenginejournal.com/the-text-only-version-of-your-website-strips-out-the-wrong-layer/590088/
- Search Engine Journal,《Google Gemini Adds UTM Parameters For Referral Attribution》:https://www.searchenginejournal.com/google-gemini-adds-utm-parameters-for-referral-attribution/591754/
- Search Engine Journal,《Meta Drops Training From Its Crawl Clause And Keeps The Crawl》(2026-10-19,含 Meta 新版商业条款与 Benjamin Sobel 观点):https://www.searchenginejournal.com/meta-removes-training-crawl-clause-commercial-terms/593584/
- Google Search Central,《生成式 AI 搜索优化指南》(含 agentic experiences 一节):https://developers.google.com/search/docs/fundamentals/ai-optimization-guide